
Agent Engineering:重试、状态与执行控制
一个 Agent 的基本循环很简单:接收输入,调用模型,执行工具,再把结果交回模型。复杂性往往出现在两个步骤之间。参数还没收全,工具已经开始;请求失败了,文件却已经改过;用户点了停止,旧任务仍在提交结果。
这些情况都要求运行器区分已经成立的事实、尚未结束的工作,以及下一步使用的状态。请求能否重发,取决于上次尝试已经推进到哪里;历史能否裁剪,取决于消息之间的协议关系;任务能否结束,取决于产物是否获得了对应的验收证据。
目录
按故障查阅
| 遇到的现象 | 优先查阅 |
|---|---|
| 一次失败后等待很久,或多个客户端同时重试 | 重试资格与预算、退避与截止点 |
| 输出到一半断流,恢复后重复操作 | 流式恢复、幂等操作、日志与投影 |
| JSON 校验通过,工具却执行了半截意图 | 截断参数 |
| 并行工具的显示、记录和执行顺序混乱 | 三种顺序 |
| 工具调用成功,却漏读结果或无法继续取数 | 工具返回值、可恢复引用 |
| 点了停止还在写,切换会话后出现旧结果 | 取消与收尾、迟到唤醒 |
| 回滚后设置没回滚,或读到了另一条尝试路线 | 恢复路径 |
| 压缩后 API 报协议错误,或反复压缩仍超限 | 合法切口、上下文预算、压缩失败 |
| token 已减少,调用仍慢,或压缩后找不回原文 | 缓存复用、可恢复引用 |
| 新输入被忽略,或权限回调突然报 Stream closed | 输入边界、迟到唤醒、双向协议 |
| 用户拒绝操作后,Agent 换个工具继续做同一件事 | 拒绝与纠正 |
| 记录显示完成,应用却不能用 | 交接检查、完成证据、Harness 退役 |
一、请求恢复
重试资格与请求预算
指数退避回答的是“多久再试”,此前还要回答“这次失败能不能再试”。暂时过载、账户额度耗尽和上下文溢出,即使都表现为 API 错误,恢复动作也不同。后两种情况原样重发,通常不会因为多等几秒而变好。
Pi 的重试路径先排除 context overflow,再由错误分类器排除额度、账单和订阅限制,最后识别暂时过载、限流及网络错误。这里仍有文本模式匹配,不能把分类结果当作永远准确的服务端契约;接入新 Provider 时,错误样本也是兼容性测试的一部分。源码:Pi 错误分类、分类谓词、重试入口
重试次数还需要明确是否包含首轮请求。Codex 的 run_with_retry 使用 0..=max_attempts,总请求数上限为配置值加一。Pi 的测试也明确断言:maxRetries=2 对应最多三次请求。源码:Codex 请求循环、Pi 次数断言
OpenCode 又区分了 timeout:默认超时最多重试三次,普通暂时性错误最多十次,插件可以改写决策。一次超时已经消耗了整段等待,不能和立即返回的 503 只按异常个数等价计费。源码:OpenCode 重试策略
重试配置应分别定义可重试错误、最大重试次数、单次请求超时和整项操作的截止点。若两层各允许两次重试,最坏可能形成九次底层请求;必须指定谁拥有哪一段预算,或在外层保留共享上限。次数限制约束请求量,整体 deadline 约束用户到底要等多久。 这两种约束应同时存在,等待本身也应响应取消。
单项任务最多重试两次,仍挡不住一千个任务同时失败。退避改变请求发生的时间,整体恢复额度则约束同一依赖承受的额外流量。令牌桶可以允许有限突发,再按补充速率放行;额度不足时延后或结束恢复,等待仍受任务截止点约束。工程实践:共享重试额度
用于 Agent 服务时,共享范围可以按 Provider、账户或依赖划定。每个会话各自创建一个满桶,会再次放大总额度;进程内桶也无法约束其他进程。共享重试额度只控制额外尝试,首轮请求仍需自己的准入与并发控制。
指数退避、随机抖动与 Retry-After
本地退避可以写成 base × 2^(k−1),再设置上限。随机抖动使不同客户端的下一次请求不落在同一个时刻,减少同时失败、同时恢复的同步现象。Codex 的 HTTP 重试 helper 使用约 ±10% 的乘性抖动,本身没有等待时长封顶;等待上限和整项操作的截止点仍需由外层约束。源码:Codex backoff
服务端的 Retry-After 是另一种约束。假设收到“10 秒后再试”,随后通知 UI、等待锁花了 8 秒。上层若重新 sleep(10s),一次建议就被重复等待;每多经过一层恢复逻辑,延迟都可能增加。
Codex 在接收建议时就把它转换为单调时钟上的 Instant。常规 HTTP/Responses 重试和传输 fallback 分支沿用同一个 deadline,只等待剩余部分。HTTP-date 先借助墙上时钟换算,之后的等待使用单调时钟。它还保留一个重要区分:有效但已到期的建议,和没有有效建议,是两种状态。 前者剩余时间为零,后者才走本地退避。源码:RetryAfter、跨层等待
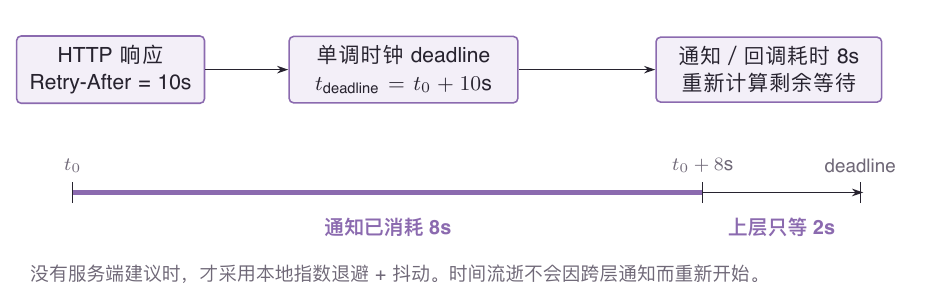
接口可以同时传递“何时允许再试”和“整项操作何时必须结束”两个截止点。若前者已经达到后者,就直接返回预算耗尽。服务端建议还需要合理性校验;OpenCode 的默认策略会把它截到十五分钟,插件可以覆写。
下面以“有效服务端建议优先”为例,把有上限的本地退避与整体预算放在同一个控制路径中:
delay = min(cap, base * 2**(k - 1) * uniform(0.9, 1.1))
ready_at = server_deadline if server_deadline is not None \
           else monotonic_now() + delay
if ready_at >= operation_deadline:
    return BUDGET_EXHAUSTED
await sleep_until(ready_at, cancel_token)
return await request(deadline=operation_deadline)
server_deadline is not None 保留了“已经到期”与“没有建议”的区别。等待和请求都要实际支持取消与截止点,才能约束整体耗时。这里的 cap 与 operation_deadline 是设计示意中的外层限制,并非 Codex HTTP helper 已提供的全部行为。不同策略也可以取服务端建议与本地退避的较大值;关键是明确选择规则,只执行一次等待。
流式失败与接续
流式调用的危险在于:请求还没有结束,执行现场可能已经改变。模型发出了一个完整工具调用,工具写入文件,随后连接在最终 completion 之前断开。此时重发最初 prompt,会让模型依据旧现场再次作决定。
Codex 收到 OutputItemDone 后即可启动对应工具,不必等整条响应完成。流循环报错返回之前,它仍会收集已经启动的工具结果,写入历史;下一次采样从更新后的会话历史构造输入。这种顺序保留了恢复所需的事实,也意味着慢工具可能推迟重连。源码:提前启动工具、错误后收集结果、重试重建输入
OpenCode 把可恢复失败分成 Retry 和 Continue:尚无输出时透明重试;text、reasoning 或工具输入已经开始以后,保留部分尝试,再让下一轮接续。判断依据是输出是否开始,不只看工具是否产生外部写操作。两条路径共享预算,切换恢复方式不会让次数归零。源码:Retry 与 Continue、已有输出的接续、输出开始边界、共享预算测试
恢复器可以先收齐已启动工具的结果,再根据输出边界选择重发或接续。下面是结合上述分工的设计示意:
await settle_started_tools()
decision = shared_retry_budget.decide(error)
if not decision.retry:
    return terminal_failure(error)
if not output_started:
    return Retry(decision)
await close_failed_attempt(error)
return Continue(decision)
terminal_failure 记录失败并结束恢复循环;close_failed_attempt 保留已有输出与失败事实。Continue 随后依据更新后的历史重新采样。
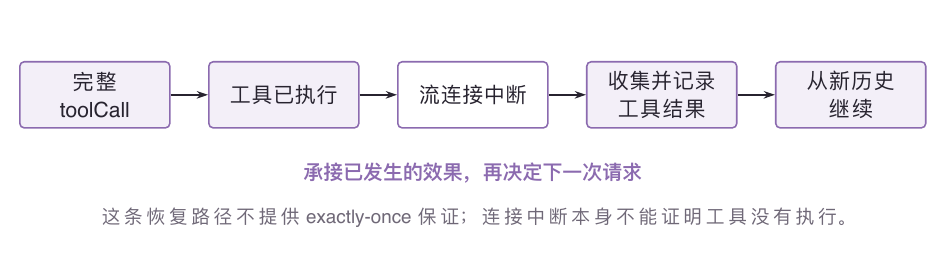
这仍然不提供外部操作的 exactly-once 保证。远端可能执行成功,却在返回结果前丢失连接;模型也可能提出一个新的、语义相同的调用。尝试 ID 追踪物理请求,逻辑操作 ID 识别同一业务动作;有代价的远程写操作需要另做幂等键、状态查询或补偿。接续提示可以减少重复表达,不能承担支付、发信等操作的去重责任。
幂等键、原子提交与迟到请求
参数相同不能证明是重复请求:用户可能确实需要两个相同对象。同一业务操作跨重试复用同一幂等键,新操作使用新键;服务端按调用者与键绑定原始参数,同键异参数应拒绝,同键同参数则恢复已有结果。AWS:幂等操作契约、Stripe:重试与服务端状态
模型重新采样后产生的 tool-call ID,不天然等于跨尝试稳定的业务操作 ID。后者需要由业务层保存,不能在每次网络重试时重新生成。
“先查重,再执行”还会留下竞争窗口。对于能放进同一数据库事务的修改,可以把去重记录、业务变更和结果放在一个提交单元中:
sig = canonical_fingerprint(payload)
with db.transaction():
    row = lock_or_insert(caller, key, sig)
    require(row.sig == sig, PARAMETER_MISMATCH)
    if row.done:
        return row.result
    result = mutate_in_same_transaction(payload)
    row.complete(result)
return result
这里的 lock_or_insert 依赖唯一约束和锁,使同一调用者、同一键的竞争串行化。事务确定回滚时,三者均不生效;提交结果未知时,应沿用原键查询或重试,不能直接判定回滚。事务已经提交而响应丢失,重试则读取已有结果。原子提交要求
远程发信并不在这个数据库事务中。对外部副作用,需要下游幂等契约或可查询、可恢复的操作状态;只在本地记下“已经调用”不能证明远端已经完成。远程调用的不确定性
资源删除后仍可能收到旧请求,去重记录的保留窗口应独立规定,避免迟到重试重新创建资源。迟到请求与保留窗口 由此还需要区分去重与取消:若服务端从未收到过该键,取消后的迟到首发仍可能执行。需要阻止这种执行时,还要有服务端认可的撤销或执行期限,检查点应接近实际副作用。
二、工具执行
工具参数的完成边界
流式 JSON 解析器有时会补上缺失的引号、括号,使半截输出仍能解析。若参数要求一个字符串,原本打算生成 hello,截断后得到 hel,它仍可能满足 schema。语法正确、类型正确,都不能证明模型已经把动作说完。
Pi 在 stopReason=length 时跳过工具执行,为该条 assistant 消息中的所有工具调用生成错误结果,再允许后续轮次完整重发。即使其中一个调用看起来已经完整,也会随整批一起被拒绝。对应测试特意构造了能通过 schema 的 {value:"hel"},确认工具没有执行。源码:length 分支、整批拒绝、参数合法仍不执行的测试
这是一个保守取舍:牺牲一部分本来可以执行的调用,换取清晰的完整性边界,也会增加一次模型请求。它适用于该 Pi 路径;不能据此反推所有系统都必须等完整 response 才能执行。Codex 的工具 item 完成边界与这里的整批策略不同,见 流式失败与接续。
工具入口还需要分别检查生成完整性、参数、授权和业务前提。解析器修复数据形状,“修复后可解析”不足以放行动作。
并行执行与有序提交
两个工具 A、B 依次被调用,B 先完成。为了及时反馈,UI 应能先显示 B;为了稳定重放,模型历史又可以保持 A、B 的调用顺序。这两种需求并不冲突,前提是完成事件与结果提交使用不同规则。
Pi 的并行路径在各工具实际完成时发出 tool_execution_end,随后通过 Promise.all 按输入顺序收集结果,并按原始调用顺序写出 toolResult。测试明确断言:完成事件顺序可以是 B、A,而结果记录仍是 A、B。若同批任一工具声明 executionMode=sequential,整个批次转为串行。源码:并行执行与结果收集、结果保序、顺序测试
Codex 使用共享/独占 gate 控制标记为可并行或不可并行的调用,并用 FuturesOrdered 有序收集结果。这里的共享锁不能解释为“只读工具”,源码测试允许 shell 并行;gate 也不会自动分析两个 shell 是否写同一个文件。源码:并发准入、shell 并行测试、有序收集
Pi 的批次控制可简写为:
serial = config.tool_execution == sequential \
         or any(call.requires_sequential)
mode = sequential if serial else parallel
jobs = launch(calls, mode, on_complete=emit_completion)
results = await collect_in_input_order(jobs)
for call, result in zip(calls, results):
    append_tool_result(call.id, result)
完成通知由各任务发出,历史结果由批次统一提交,二者通过调用 ID 对应。运行器能否并发、资源之间是否有读写依赖、结果按什么顺序进入上下文,是三个独立问题。支持并发只回答第一个。更细的资源键、读写集或依赖图可以提高并发度,但也提高声明和校验成本;信息不足时应保守串行。按调用顺序提交还会带来队首等待,不能同时承诺“确定顺序”和“所有结果立即进入模型”。
取消与终态结算
点击停止只表达了新的控制意图。它不自动撤销文件修改,也不能把一个已经成功的工具改写为未执行。尤其当工具已经返回、观察器还在处理完成事件时,迟到的取消很容易制造错误历史。
Codex 的工具封装会检查是否已经达到 terminal outcome;若已经完成,就保留真实结果,避免再补一个 aborted 结局。仓库测试故意阻塞完成观察器,再发取消,确认最终生命周期仍只有 Completed。源码:完成与取消竞争、竞争测试
会话层也需要收尾顺序。Codex 先发取消信号,给任务一个短暂的合作退出窗口,再执行必要清理;启用中断历史标记时,先写标记并 flush,再发 TurnAborted。客户端收到通知后可能立即读取日志,这个次序影响恢复时能否看到中断事实。flush 失败时实现会告警并继续,因此通知到达仍不等于标记已经持久化。源码:取消与清理
OpenCode 把实际工作放在可中断区域,把终态事件与状态结算放在受保护的收尾区域。Claude Agent SDK 关闭子进程时,也会在有界等待后逐级 terminate、kill。工作可以取消,终态记录仍需要完成;清理的等待也需要单独约束。源码:OpenCode 收尾区域、OpenCode 终态结算、Claude SDK 进程关闭
取消路径需要把停止工作和提交终态分开。下面的设计示意在进入第一个等待之前保护收尾路径,停止等待与整个收尾也分别有截止点:
request_cancel(work)
with bounded_finalizer(finalize_deadline, shield_cancellation=True):
    await stop_or_escalate(work, stop_deadline)
    for call in calls:
        call.settle_if_pending(observed_outcome_or_unknown(call))
    await persist_history()
    emit_turn_terminal()
settle_if_pending 原子地保留已有终态,已完成的结果不能被迟到取消覆盖。收尾超时或写入失败要明确上报,取消保护本身不提供持久化事务。
cancel acknowledged、execution stopped 和 settlement completed 分别表示取消已接收、执行已停止、收尾已完成。复用同一执行现场或替换会话状态前,需要等待最后一个边界。若远端调用结果无法确认,应保留“结果未知”和查询线索;把未知统一标成失败,会诱导下一轮重做已经成功的动作。
工具返回值与可行动的错误
工具成功返回,不代表模型得到了足够的下一步信息。搜索结果若只有难以理解的 ID,模型缺少选择依据;若删掉所有 ID,后续读取又没有准确目标。返回值应同时照顾判断所需的语义和继续调用所需的标识,大结果则提供过滤、分页或范围读取。工程实践:工具返回值设计
例如,有限条数的搜索回包可以明确区分“没有更多结果”和“只返回了一部分”:
{
  "items": [{"id": "doc_7", "title": "接口约束"}],
  "truncated": true,
  "next_cursor": "c_2",
  "returned_scope": "当前筛选的一页结果"
}
truncated 说明信息不完整,next_cursor 给出继续取得信息的入口。缺少这两项,模型可能把“未展示”误认成“不存在”。简洁回包可以减少噪声,但不能删去下一步必须使用的字段。
错误回包也可以提供可行动信息:指出哪个参数违反了约束、允许的值是什么,或建议缩小哪一段范围。这样才能把“调用失败”变成“下一次调用应如何修正”。工程实践:截断与错误反馈 这里处理的是可修正错误;权限拒绝与取消仍走独立控制路径,不能包装成鼓励模型继续尝试的提示。
三、会话状态
原始日志与模型投影
失败的半截回答不适合反复送给模型,但直接删除它,会失去排查失败和核对费用的依据。会话存储同时承担审计和推理输入,两种用途需要不同视图。例如原始日志保留 e1, e2, edit(e2, null),模型投影则省略 e2;删除效果本身也有记录。
Pi 重试时通过 _omitRecoveryAttempt 追加 context_edit(targetId, null),在模型投影中省略失败尝试,原始条目仍保留。编辑自身也是新 entry;它只作用于活动分支,同一目标的最后一个编辑生效。若目标仍在上下文中却无法找到来源 entry,代码会报错,而非静默丢失来源关系。源码:省略失败尝试、投影规则、追加编辑
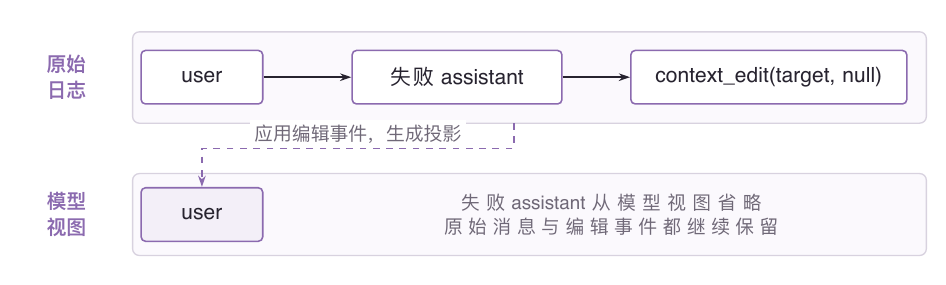
这个结构让“曾经发生过什么”和“下一次模型应该看到什么”都能解释清楚。代价是所有读者必须理解投影:token 估算、压缩、重放和调试界面如果各读一套记录,就会出现显示已省略、预算仍按旧文本计算的偏差。原始日志也仍然占磁盘,隐私删除需要另一套策略。
进入上下文的内容应保留 source ID,把省略、替换及压缩记录为可追踪的变换。审计视图展示原始事实,模型视图展示有效输入,并能从后者回到前者。可解释的恢复,依赖可解释的上下文来源。
失败信息是否进入下一轮,还取决于它能否改变决策。断流留下的重复草稿可以省略;测试失败、路径不存在或业务前提不成立,则需要保留观察,避免再次走同一条失败路径。保留失败观察是 Manus 提出的重要经验。工程实践:保留失败观察
用于日志投影时,可以保留短结论、适用范围和原始证据位置,省略重复堆栈。暂时故障不能固化为永久禁令,结果未知也仍需标为未知。选择依据是失败带来的信息,而不是统一按 isError 删除或保留。
分支、回滚与恢复
一个会话文件可能同时包含失败路线、回滚事件和新分支。按文件顺序读出全部消息,不一定得到当前上下文;只找到最近摘要,也不一定得到可用的恢复点。
Pi 的 entry 带 id 和 parentId,活动 leaf 决定当前路径。切换分支只移动 leaf,后续追加产生新分支,旧节点仍然存在。构建上下文时沿 parent 回到根,再还原有效顺序。存储顺序描述写入经过,因果路径描述这次决策继承了什么。源码:沿叶子重建路径、分支切换
Codex 的 rollout 恢复还处理 rollback、上下文基线和模型设置等元数据。它先反向识别仍有效的分段与 checkpoint,再正向重建历史。测试同时检查回滚后的正文、previous settings、reference context 和 attribution,避免出现“消息退回去了,内部设置仍停在未来”的混合状态。源码:反向识别、同步回滚测试
OpenCode 的消息读取使用 session 内显式 seq 分页,测试刻意打乱字符串 ID 和时间戳。时间戳用于展示,显式 seq 用于重建顺序,字符串 ID 无须承担排序职责。测试:打乱 ID 与时间、源码:消息顺序
恢复契约应包含当前分支、有效 checkpoint、配置与投影版本,并用同一批用例验证。还要单独注明:对话回滚不会自动回滚工作目录或远端系统。 恢复后应重新核对现场;若需要完整环境回滚,就要另有 Git、快照或业务补偿机制。
四、上下文管理
压缩边界与工具协议
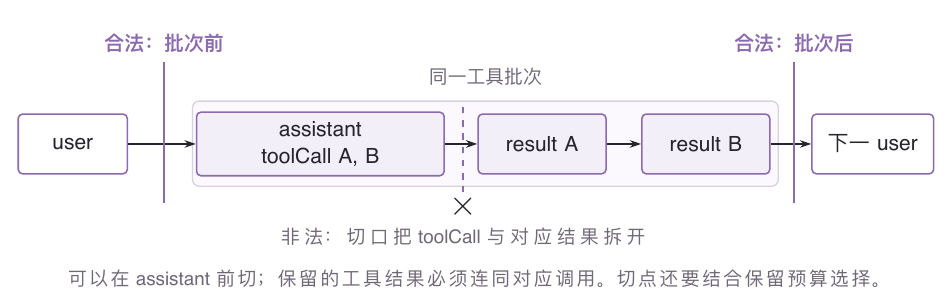
“保留最后 N 条消息”看起来简单,却可能从 toolResult 中间开始,留下没有前置调用的结果。上下文裁剪改变的不只是长度,也可能破坏模型 API 的消息协议。
Pi 的合法切点不允许从 toolResult 开始;预算选择基于当前有效投影,必要时保留同一轮的前缀供摘要处理。OpenCode 则把近端边界退回 user message,让同一 exchange 的调用和结果一起处理。两者切分粒度不同,不能概括成所有实现都只在完整 user 轮次切分。源码:Pi 合法切点、投影中的边界、OpenCode exchange 边界
中断还可能留下有调用、无结果的历史。Pi 的消息适配层会为缺失结果补入 isError=true 的占位,说明 No result provided。这修复了结构,却没有证明工具未执行。若远端结果未知,占位表达的只能是“没有观察到结果”。源码:缺失结果修补
裁剪顺序应当是:先确定不可拆分关系,再找满足预算的边界,最后说明哪些内容被摘要、文本化或丢弃。OpenCode 的 recent exchange 会序列化为文本放在摘要旁,并非原始协议消息无损保留。若一组工具结果本身特别大,合法边界也可能超过目标预算;此时应缩减工具输出或调整下一步任务,不能偷偷破坏配对。
上下文预算与度量失效
上次 API 返回的 usage,只测量了上次模型见到的内容。随后本地工具读入一份大文件,下一请求已经变大,但旧 usage 仍可能显示“空间充足”。只盯着最后一次 token 数,会在工具输出之后低估上下文。
OpenCode 的 estimatePrompt 使用最近可信的 Provider 实测 usage,加上此后未测内容的估计量,尤其补上本地工具结果。若切换 Provider,也不能无条件信任另一个 Provider 的计数。窗口计算优先采用输入上限,再使用 context 上限;默认还预留缓冲,显式配置可以覆盖。源码:estimatePrompt 与 ceiling、工具增长与输入窗口测试
这个预算可以理解为:可信实测基线 + 新增内容估计 + 下一步预留。预留要考虑下一次输入增长和模型接口定义;不同 Provider 对输入、输出和总窗口的限制关系并不一致,不能机械地从所有窗口里扣掉同一个最大输出值。
更容易遗漏的是度量失效。压缩后仍沿用压缩前的 usage,会立刻再次触发压缩。Pi 会核对响应模型,避免把旧模型的溢出错误用于新模型恢复;再核对压缩边界,避免把压缩前的 usage 用于新一轮阈值判断。全零 usage 时改用估算,而非把零解释为没有上下文。源码:响应模型核对、度量来源与压缩判定
token 数应与“测量对象、模型、对应日志边界”一起保存。一个没有来源边界的数字很难安全复用。预算仍是估计,协议配对、图像和超长工具结果都可能产生偏差,因此还需要 压缩失败与基线提交 的超限恢复出口。
压缩失败与基线提交
压缩请求本身也要把输入交给模型。若它同样超窗,原样重试压缩不会让输入变短;若半截摘要立即替换旧历史,失败还会毁掉最后一个可用基线。
OpenCode 在压缩超限后逐步缩小输入,以首次进入收缩分支时的请求估计为固定基线,把目标比例依次调低到 0.7、0.5、0.35。无法在保留最新 exchange 和 checkpoint 的条件下继续收缩时,就显式失败。缩小输入是一种可观察的恢复进展;固定次数保证恢复路径本身也有出口。源码:输入收缩、比例与边界、失败出口测试
Codex 的 PostTurn 压缩路径会暂存摘要输出,等 response.completed 后才构造替换历史,避免失败的半截摘要污染当前基线。完成后替换是这一特定路径的提交语义。源码:摘要暂存、完成后替换
摘要“生成成功”还不等于“重要事实完整”。OpenCode 的一个轻量检查只要求输出含有模板中的至少一个标题。通过这个谓词,仍可能缺少其他章节、关键决策或未完成工作。源码:标题存在性检查
候选摘要与当前基线可以分开保存,发布点放在完成标记与约定检查之后:
old = current_baseline
candidate = await summarize(history)
if not candidate.response_completed:
    return FAILED_KEEP(old)
if not validate(candidate):
    return FAILED_KEEP(old)
await save(candidate)
current_baseline = candidate.id
这是基线提交的设计示意,validate 需要具体规定检查哪些内容。保存与切换引用之间的崩溃恢复,还需要持久层提供相应保证。每次超限恢复则应缩小输入或改变与故障有关的量,并设置明确出口;原样重复同一份失败输入不会取得进展。
稳定前缀与缓存复用
支持前缀缓存的后端,可以复用相邻请求的共同输入。靠前的时间戳、工具定义变化或不确定的序列化顺序,都会缩短可复用前缀。稳定指令和工具定义尽量靠前,新增观察随后追加;具体命中仍取决于后端的缓存粒度、保留时间与路由。工程实践:围绕前缀缓存设计
request_1 = stable_prefix + history_1
request_2 = stable_prefix + history_1 + new_observation
日志只追加,不代表模型输入也只追加。一次 context_edit 可以改变较早的模型投影,压缩也可能替换大段历史。因此,审计日志的保留策略与模型请求的缓存策略需要分别检查。比较压缩收益时,还要统计后续请求的累计延迟和费用;必要的事实纠正、权限更新与预算约束仍优先于缓存命中。
上下文卸载与可恢复引用
摘要保留当前判断,外部引用保留重新取得证据的入口。大文件、网页或查询结果可以留在窗口外,通过文件路径、链接和存储的查询条件按需读取。这样,暂时不加载全文与永久丢失信息就成为不同选择。工程实践:按需取得上下文
可恢复引用需要满足比“记住一个地址”更强的条件。路径可能被覆盖,URL 可能变化,跨会话权限也可能失效。需要重现当时证据时,应保存快照或版本,并保留内容哈希和定位信息;哈希能检查取得的内容,却不能让已经丢失的内容重新出现。
按需读取也有往返成本。当前决策立即需要的约束适合预先加载,大体量证据再通过工具取得;若某份资料每一轮都会重读,持续卸载可能比保留摘要和关键片段更慢。卸载策略需要同时设计保存位置、重新读取的方法和读取时机。
五、控制与交互
Steering、Follow-up 与 Abort
用户在运行中补充“先看另一个目录”,可能只是希望改变下一步,并不希望把正在完成的工具结果丢掉。输入注入既要及时,也要遵守工具协议,不能随意插在 toolCall 与 toolResult 之间。
Pi 把 steering 和 follow-up 分成不同队列。当前版本在整批工具结果完成、当前 turn 收尾后读取 steering;内部循环自然结束时再处理 follow-up。steering 不会在每个工具完成后立即打断同批剩余工具。若压缩等 prepareNextTurn 耗时,且准备前没有取到输入,准备后还会补检查一次,接住等待期间到来的消息。源码:准备后补轮询、工具批次后的调度
这里的第二次检查有一个细节:只在此前 pending 为空时补查,避免 one-at-a-time 队列在同一轮多取一条。它既解决新输入的时效,也保持队列消费语义。
输入接口需要区分三种意图:下一安全边界改变方向、当前工作自然结束后追加任务、立即请求取消。前两种进入调度队列,第三种进入取消路径。产品只提供一个含糊的“发送”,运行器就只能猜测用户到底要什么。安全边界会带来等待;对耗时工具,还需要明确展示新指令已排队,以及何时生效。
Lost wakeup 与收尾调度
新输入到来时,若 runner 正忙就不再启动一个;runner 处理完队列后转为空闲。这个看似合理的规则会在退出窗口丢失唤醒:旧 runner 最后一次检查队列为空,已经决定结束;新输入随后入队,看见 runner 仍是 busy,便跳过启动;旧 runner 切换 idle 并退出。此时队列里有工作,却没有执行者。
OpenCode 的 coordinator 用 pendingWake 作为门铃。drain 后发现门铃就再检查工作;若唤醒发生在收尾窗口,还会启动 successor。它同时区分 interrupt 的立即确认、当前 execution 的 awaitSettlement,以及包含后继运行的 awaitIdle。源码:drain 与门铃、接口等待语义、收尾窗口与等待语义
收尾窗口的关键逻辑是:先完成可能等待的 cleanup,再同步检查门铃并移交执行权。
wake(key, scope):
    if e := active.get(key):
        e.pending_wake = merge_scope(e.pending_wake, scope)
    else:
        active[key] = start(key, scope)

finish(e):
    await cleanup(e)
    without_await:
        if e.pending_wake:
            active[e.key] = start(e.key, e.pending_wake)
        else:
            del active[e.key]
这是 late wakeup 路径的简写。正常 drain 也会消耗门铃并重新检查工作;合并时 INPUT 覆盖 STEER。start 只安排异步 drain 并返回执行记录,同步段完成 active 登记,因此新 wake 无法插入“检查完门铃、尚未切换状态”的空隙。
门铃表示“还需要检查一次”,可以合并多次唤醒,并不保存任务内容。这里的 executions 是进程内 Map,without_await 也只是同进程协作调度边界。跨进程互斥、任务持久化与断电恢复需要另外实现。
竞态测试需要覆盖最后一次 drain 前、drain 后而 idle 前,以及取消清理期间。取消前积累的旧唤醒可以被清除,但取消后新提交的用户意图仍要运行。正常路径测试很难覆盖这段窗口,最好用 barrier 精确控制时序;OpenCode 的测试正是通过阻塞收尾来验证迟到唤醒。测试:收尾期间的新输入、取消后的唤醒
双向控制协议与通道生命周期
把 CLI 包成 SDK 时,很容易以为“写完 prompt 就可以关闭 stdin,随后只读 stdout”。但若工具权限、hook 或 SDK 内 MCP server 由父进程处理,CLI 还需要从 stdout 发控制请求,再从 stdin 收到对应回复。输入通道承担的已经不只是用户 prompt。
Claude Agent SDK 的 _has_bidirectional_needs 正是检查这些配置,并延后关闭 stdin。一个 result frame 只结束一轮,后台任务仍可能唤醒父 Agent,后续轮次还会发权限或工具控制请求。过早关闭会让这些请求失败为 Stream closed。源码:双向需求与 run 结束
传输层还有独立边界:一次 pipe read 不等于一条 JSON 消息。SDK 按行重组 stdout 的 NDJSON,检查完整行与未完成缓冲的长度;EOF 时可以接受合法的无换行尾帧,但不能把截断 JSON 当作完整消息。源码:消息分帧
这要求分别建模 prompt 输入完成、控制通道可关闭、单轮结果结束和整个 run 结束。控制请求要有 ID、超时与失败唤醒机制;reader 终止时,不能让所有待回复请求各自等到超时。旧 CLI 不报告 session state 且排队多个异步 prompt 时,关闭判定仍有未覆盖的情况,当前 SDK 在相邻注释中保留了这一限制。
权限拒绝与纠正反馈
用户拒绝一个工具,有时意味着“停止这次操作”,有时附带“换到测试目录”。若统一当普通 tool error 返回模型,模型可能换个工具继续执行同一个意图;若统一终止,又会丢掉有价值的纠正反馈。
OpenCode 将无反馈拒绝和带反馈拒绝分别表示为 DeclinedError、CorrectedError。前者沿停止当前轮次的路径传播,避免被工具叶子的通用错误处理吞掉;后者可以转为模型可见反馈,允许下一轮按新约束继续。拒绝还会传递给同 session 的其他 pending 权限请求,收束并行批次。源码:两种控制语义、停止与纠正测试
回复处理位于取消保护区,同 session 的等待请求收到一致的控制信号:
reject(request, feedback):
    signal = CorrectedError(feedback) if feedback else DeclinedError()
    for pending in same_session_requests(request):
        publish_replied(pending, REJECT)
        fail_waiter(pending, signal)
        remove_pending(pending)
“始终允许”也不应直接放行所有旧请求。OpenCode 会重新评估等待请求;已经改变的配置 deny 仍能阻止它。授权是在当前约束下作出的判断,不能只复用几秒前的队列位置。源码:重新评估等待请求
用户停止、方向纠正、配置策略拒绝需要不同的传播路径。可恢复的业务故障可以成为模型反馈;权限拒绝和取消则由运行器维护控制效力,不能由下一轮模型重新解释为执行许可。
六、交接与验收
跨会话交接与回归检查
跨会话交接需要目标、进度和可恢复版本,但这些记录只描述上次观察。依赖可能变化,服务可能没启动,上次测试也可能遗漏回归。读取交接文件以后,还要重新建立对当前环境的信任。
Anthropic 的长程 Harness 把初始化与后续增量工作分开,用功能清单、启动脚本、进度记录和 Git 支撑接手。后续编码提示规定了接手顺序:先启动环境,重测一两个此前已通过的核心功能,发现回归先修复,再开始新功能。官方文章:长程 Harness、官方示例:接手与回归检查
基线检查不需要每轮重跑全部昂贵测试,但要覆盖继续工作所依赖的关键路径。若刚修改认证逻辑,仅检查首页能打开就不足以支持后续工作;重测范围取决于改动影响、成本和风险。
另一个边界是功能清单的保护。提示要求仅更新 passes,不能删改验收内容;这是一条 prompt 约束,示例不能因此自动获得 ACL 或确定性校验。需要强制保护时,可以冻结验收规范或比较不可变字段,由运行器验证允许的状态变更。测试应由外部条件决定,不能在失败后随手改写成容易通过的版本。官方示例:功能清单约束
交接记录还应区分已验证事实、未验证推测和下一步建议,并附上验证所对应的版本或产物。下一位 Agent 既能快速接手,也能判断哪些结论需要重新检查。
运行终态与任务验收
“完成”必须说明完成了哪一层。收到 response.completed 等协议完成标记,才说明对应响应完整结束,连接关闭或 EOF 本身不能证明完成;轮次停止,说明本轮控制流进入终态;任务验收则要求产物满足目标。这三个边界不能通过事件名字互相推导。
Codex 的 TurnComplete.error 可以携带本轮的终态错误,消费方需要读取这个字段。Claude Agent SDK 则会把 CLI 先返回的结构化错误结果保留下来,避免随后非零退出把真实原因压扁成“exit code 1”;同时唤醒所有待处理控制请求,让它们得到同一个终态原因。源码:TurnComplete 的错误字段、Claude SDK 错误保真
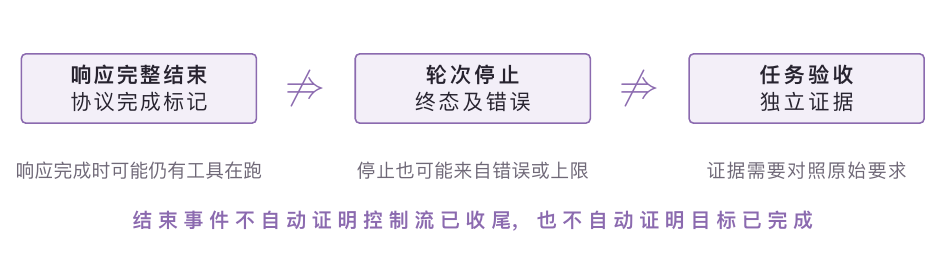
Claude Code 官方 Ralph 插件提供另一种观察:stop hook 检查输出中的 <promise> 是否匹配约定字符串,匹配就结束循环。它是停止信号,并非独立测试证明。同样,长程 Harness 示例的外层循环能自动开始新会话,但代码没有把“所有功能通过”作为确定性退出门;打印进度与验证完成是不同职责。源码:Ralph completion promise、官方示例:外层循环
状态模型应分别记录运行终态和验收状态:运行可以正常结束但尚未验收,也可以因预算停止而留下部分成果。验收证据绑定具体产物版本、检查项和结果;修改产物后,受影响的证据需要失效或重跑。另一个 LLM 的“看起来不错”可以提供意见,但不能替代可执行检查和真实环境观察。
run_status: completed | failed | cancelled | budget_exhausted
acceptance: pending | passed | failed
evidence:   artifact_version + checks + results
验收主要检查任务结束后的产物与环境状态,并核对任务明确要求的过程约束。两条工具路线都满足要求时,不应因为调用顺序不同就拒绝其中一条。trace 用于诊断失败、核对授权和成本;固定工具顺序只在任务确实要求该顺序时才属于验收条件。工程实践:评分器与合法替代路径
Harness 的评估与简化
一个工程补丁常常针对某个模型的具体弱点:过早收工、临近上下文上限时收缩工作,或一次推进过多功能。模型升级以后,这些机制可能仍有帮助,也可能增加重启、摘要和协调成本。
Anthropic 后续的 Harness 设计文章记录过这种调整:模型能力变化后,部分上下文重置和 sprint 切分被简化,评估方式也随之变化。官方文章:Harness 的迭代
可以给每个机制写一份短契约:针对什么故障,靠什么指标判断有用,增加多少时间与调用成本,什么条件下应移除。模型或工具升级后,在相同任务集与预算下比较保留、关闭两种版本,观察最终验收率、恢复失败率和总成本。总轮数增长不一定意味着更强,也可能是系统在反复补救自身造成的问题。
验收规范最好在实现之前固定;如果需求改变,就显式更新规范版本。对于生成器与评估器分离的流程,也要防止它们共同依赖错误假设:浏览器是否真的操作了页面,测试是否真的覆盖要求,评估器是否读取了最新产物,都需要可核对的证据。Harness 负责持续推进,也应当允许被证据修正。
比较稳定性时,还需要区分两种成功率:pass@k 关注 k 次尝试中至少一次成功,pass^k 关注 k 次全部成功。前者适合可以筛选候选的任务,后者反映重复运行的可靠性。工程实践:重复试验指标
若同一任务每次独立成功的概率为 0.8,三次里至少一次成功的概率是 99.2%,三次全部成功则只有 51.2%。这个独立同分布假设下的算例说明,多给几次机会可以提高找到可用结果的概率,却没有改变单次运行的成功率。
hits, consistent = [], []
for task in held_out_tasks:
    ok = [grade(run(task, fresh_env(task), budget_limit))
          for _ in range(k)]
    hits.append(any(ok))
    consistent.append(all(ok))
report(mean(hits), mean(consistent))
这里的重复试验从相同初始环境分别开始,不是同一执行现场中的 HTTP 重试。固定单次预算,隔离前一次产物,并记录样本数、模型与 Harness 版本,才能区分稳定性改善和单纯增加尝试次数。
不变量与故障测试
接口承诺需要对应的故障测试。下面这些条件可以直接形成回归用例:
| 不变量 | 值得专门制造的失败条件 |
|---|---|
| 同一个等待建议不会跨层重新开始计时 | 通知延迟、锁等待、切换传输方式 |
| 恢复输入能反映已经发生的动作 | 工具已执行而模型流随后中断 |
| 同一幂等键不能悄悄改变业务意图 | 并发提交同键请求、同键异参数、资源删除后的迟到重试 |
| 调用只有一个真实终态 | 完成观察器阻塞期间收到取消 |
| 投影与回放使用相同的来源和边界 | 分支切换、回滚、连续压缩 |
| 新工作不会落在 busy→idle 的空隙里 | drain 后、收尾中、取消后送入新输入 |
| 任务完成有独立且对应当前产物的证据 | 正常终止却未达标、旧测试对应新文件 |
| 卸载后的证据仍可重新取得并核对版本 | 路径覆盖、引用失效、恢复后读到更新内容 |
对于竞态,使用 barrier 和可控时钟,比反复跑“希望撞上问题”的测试更有解释力。对于恢复,至少让恢复本身失败一次。对于完成,至少测试一次“进程正常退出但验收不通过”。这些负向条件能说明系统究竟承诺到哪一步。
实现版本与范围
实现依据为 Codex、OpenCode、Pi 的公开源码,以及 Claude Code 官方插件、Claude Agent SDK 和 Anthropic 长程 Harness 示例。Claude Code 核心运行时未在官方仓库完整公开,相关结论限于这里列出的公开层次。相邻工程文章提供补充机制与设计依据,不表示这些方案已经存在于所有项目中。伪代码抽取控制关系,省略具体类型和部分分支;标为设计示意的部分是可采用的接口方案。
源码固定版本:Codex 806d9732、OpenCode 7b3d4ce3、Pi 4ac0bd8c、Claude Code 插件 2301018b、Claude Agent SDK b6e9d12f、Harness 示例 9ec32b91。OpenCode 对应 packages/core 结构,Pi 旧仓库已重定向至 earendil-works/pi。
测试链接对应已有场景和断言的静态核对,上游完整测试集未在本机运行。实现行为以相邻链接的固定提交为准。