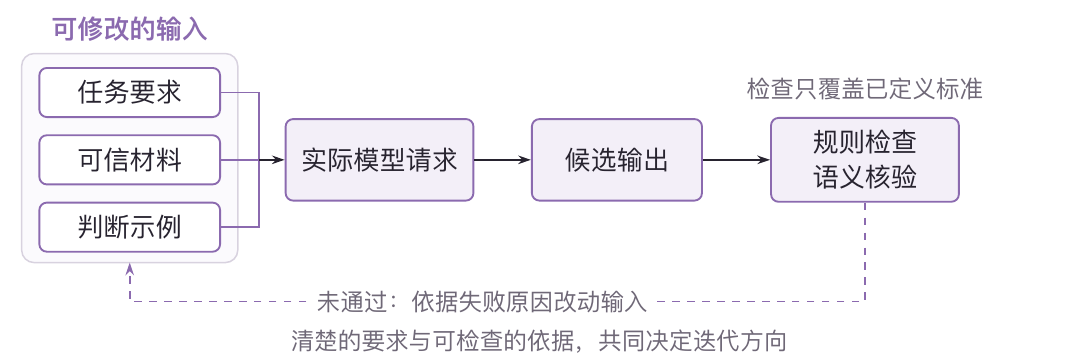
一、把任务写成可判断的要求
先说明交付物将被怎样使用
“清晰、专业、准确”表达了愿望,却没有消除多少歧义。明确受众和用途,才容易确定哪些内容应当保留、哪些内容可以省略。Ethan Mollick 在 Good enough prompting 中强调真实的任务背景、受众和迭代反馈。这些信息往往比复杂的角色设定更直接。
例如,一份项目总结可以这样约定:
根据提供的会议记录,为接手项目的工程师写一份交接摘要。
保留:已确定的决策、尚未解决的问题、下一步动作及负责人。
每项决策附会议记录中的段落编号。
不补写材料未提供的时间、负责人或承诺。
负责人缺失时标为“未指定”,不要根据发言人推断。
输出四个小节;每项只写一个决策或动作。
其中真正影响结果的是“接手项目”“决策”“未决问题”“负责人缺失时怎么办”。四个小节是展示要求,可以按界面调整。把这两类要求分开,能够避免为了满足格式而牺牲任务本身。
用途还决定信息的取舍。供负责人决策的总结可以突出影响和待选方案;交接摘要必须保留未解决的问题;面向程序的抽取则需要稳定字段。同一个提示词若试图同时满足全部用途,通常会让每一类读者承担额外的筛选工作。
将品质词改成动作、边界与优先级
“简洁”可以改成“只保留影响下一步决定的信息”;“不要遗漏”可以改成“逐项覆盖输入中的全部问题,并保留未能回答的项”;“有依据”可以改成“每个事实判断带来源编号,推测单独标记”。具体要求仍可能被违反,但至少能够定位失败。
禁止项旁边最好写清替代行为。“不要编造”没有说明缺数据时怎样交付;“为字段定义未知状态,例如允许缺失值写为 null,并说明缺项影响哪个判断”给出了可继续处理的结果。否定约束可以保留,只要不把停止行为交给模型自行猜测。
约束冲突也应有优先级。例如“每个结论附依据”与“全文不超过 100 字”可能无法同时满足。重要信息必须保留时,可以允许超出建议长度,或者要求返回无法满足的原因。否则模型可能悄悄删掉证据,以满足最容易观察的字数条件。
Anthropic 的提示词工程概览 将成功标准和测试方法列为优化前提。一个实用做法,是先用一两条真实输入写出“什么结果可以接受”,再修改提示词。只要验收仍然是“看着不错”,提示词就很容易朝更长、更像专业文章的方向漂移。
预先约定缺项与澄清的处理
要求“信息不足就追问”仍然过于宽泛。模型可能为不影响结果的细节不断打断,也可能对关键缺项自行假设。应当区分必须澄清、可以采用默认值和允许保留未知的内容。
如果缺项会改变任务范围或主要结论,先询问关键缺项。
若只是排版和语气未指定,采用适合技术读者的默认写法。
如果材料没有某个事实,但其余部分仍可完成,保留该项未知。
使用默认值时简短说明;不要将默认值写成材料中的事实。
角色提示(Role prompting)也应有具体用途。“以代码审查者的视角,重点检查异常处理和资源释放”说明了关注点;“面向有 Python 基础、刚接触分布式系统的读者”则指定了受众,有助于调整解释深度。“你是世界顶尖专家”不能补充缺失资料,也不能赋予工具权限。角色与受众设定可以帮助选择视角、语言和关注点,专业判断仍要依赖材料和检查。
二、组织材料,保留来源与边界
将规则、当前请求与待处理材料分开
一段长输入常混有应用规则、用户问题、历史对话和检索结果。模型需要辨认哪些内容定义任务,哪些内容只是任务对象。清晰分区可以减少歧义,也便于调试最终输入。
应用规则:回答范围、缺项处理、证据与输出要求。

本次资料:
<document id="D1" title="项目会议记录" version="v3">
  <paragraph id="P1">……</paragraph>
  <paragraph id="P2">……</paragraph>
</document>

当前请求:提取已经确定的决策及尚未确定的事项。
引用使用 D1:P1 这样的定位方式。
API 支持原生消息层级时,应保留它们的结构。以 OpenAI 接口为例,应用规则与用户请求具有不同优先级,详见其提示词指南。具体角色语义依提供商而定,不能把某家接口的约定直接套到所有模型模板中。
Markdown 标题、XML 标签和三引号都属于可以帮助阅读的分隔标记(Delimiters)。没有证据表明某一种分隔符在所有模型、语言和任务中最好。优先选择方便检查、转义和自动构造的格式,再用实际任务验证;不要为了排版技巧反复重写整个提示。
长材料要有导航,也要测试位置影响
长上下文解决了“能否装下”,没有自动解决“能否充分使用”。Lost in the Middle 在其测试的多文档问答和键值检索中发现,相关信息的位置会影响结果。这一观察提示了测试方向,但不能推断所有新模型都具有相同的位置曲线。
文档编号、标题、版本和段落定位,让材料具有可引用的结构。发生冲突时,模型至少能够指出是哪些来源不一致。只有“资料 A”“资料 B”而没有版本,往往无法解释两个看似矛盾的数字是否本来就属于不同时间。
对大块材料,Claude 长上下文指南 建议先放资料,再在末尾给出具体问题。这与将稳定规则放在应用指令层并不冲突:前者安排本次长输入,后者定义长期行为。它适合作为起点,最终仍应按模型和任务检验。
可以保持答案不变,分别把关键依据放在材料前部、中部和后部,再插入几段主题相近但无关的文本。若答案随位置或干扰内容明显变化,就需要改善检索、缩小输入或增加定位步骤。单纯扩大窗口,不一定减少这类失败。
选择相关材料,并允许找不到答案
只把最相似的一段送给模型,可能遗漏例外;把整个知识库塞进去,又可能让无关条款竞争注意力。材料选择需要保留支持判断的上下文,例如定义、适用范围、例外和版本说明。
让回答依托可核对的材料,通常称为 grounding。对证据密集的任务,可以要求先定位相关片段,再形成答案。定位结果只需包含文档编号、原文片段及其支持的事项,无须输出冗长的内部推理。没有找到依据时,应允许返回“材料未覆盖”,而不是强制把所有问题填满。
“未找到支持”与“存在反对证据”也要分开。材料没有提到某项功能,不能直接推出该功能不存在;两份文档分别适用于不同版本,也未必构成事实冲突。提示词可以要求区分这些状态,检查时再核对来源是否足以支持判断。
外部材料仍可能包含试图改变任务的文字。Simon Willison 的分隔符与提示词注入分析 展示了分隔符不足以提供安全隔离。标记“以下内容是资料”有助于表达意图;涉及工具、敏感数据和外部动作时,还需要由程序限制权限与数据出口。
三、Few-shot:用示例展示判断边界
Zero-shot 与 Few-shot:同一任务的两种输入
Zero-shot prompting 不提供已完成的任务示例,直接给出指令与本次输入;One-shot 提供一个示例;Few-shot 提供少量示例,再让模型处理新输入。这里计数的是输入中的演示,不是对话轮数,也不涉及在推理时更新模型权重。
GPT-3 论文中的一个经典案例,是给新词的定义,再让模型造句。原文先提供一条人工示例,后续生成的句子继续留在上下文中。下面将其新词案例改写为两种中文提示,句子作了压缩和改编。
Zero-shot 可以直接写成:
定义:yalubalu 是一种形似大南瓜的蔬菜。
请用 yalubalu 造一个自然的中文句子,含义应符合定义。
Few-shot 则先展示“定义怎样进入句子”:
定义:whatpu 是坦桑尼亚原产的毛茸茸小动物。
造句:游历非洲时,我们看到了几只可爱的 whatpu。

定义:farduddle 表示快速上下跳。
造句:玩追逐游戏时,妹妹兴奋地 farduddle 起来。

定义:yalubalu 是一种形似大南瓜的蔬菜。
造句:
合格的续写可以是“晚餐时,我们把 yalubalu 切块烤熟”。示例展示了任务形式和使用方式,答案并不唯一。这个定性案例也没有证明每次增加示例都会改善结果;对已经理解任务的模型,第一种输入可能就够用。
示例数量与示例内容是两个维度。Few-shot 可以只展示最终标签,也可以展示简短解题步骤或工具操作轨迹。因此 Few-shot、CoT 和 ReAct 可以组合,不能把它们理解为只能三选一的提示词模式。
示例应当补充规则没有说清的部分
示例能同时展示格式、语气、输入分布和分类边界。Rethinking the Role of Demonstrations 在所研究的分类与多项选择设置中,分析了这些因素的作用。该论文涉及的部分随机标签现象有特定模型与任务范围,不能据此认为错误示例无害。
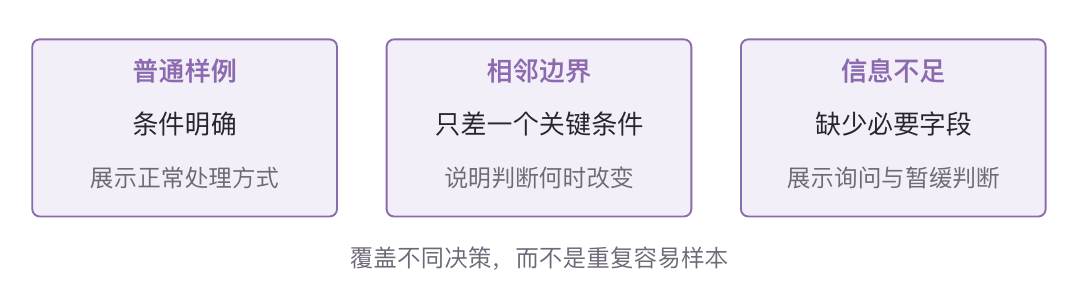
实践中,正确的例子仍是基本要求。更值得投入的是选择:一个普通样例说明通常怎样处理,一个相近但标签不同的样例说明区别在哪里,一个缺信息的样例说明何时应当停止判断。
例如,工单可以约定:已有能力在明确条件下偏离预期,归为 bug;希望增加尚未提供的能力,归为 feature;信息不足以确定前两类,归为 needs_info。以下样例比三个明显的故障更有信息量:
“导出 CSV 后,原有中文字段变成乱码。” => bug
“现在只能导出 CSV,希望增加 Excel 导出。” => feature
“导出不对。” => needs_info
此时需补充:导出格式、实际结果、预期结果。
这里的价值在于“导出不对”不会被强行归入故障。若实际业务允许先归类再补信息,就应修改规则和示例,使两者一致。例子经常比抽象规则更容易被模仿,规则与示例冲突时,增加强调语气很难稳定解决问题。
防止示例带入偶然规律
假如所有故障样例都提到“导出”,所有功能请求都提到“新增”,模型可能依赖词语而非业务定义。需要增加表述变化,也要加入关键词相似、结论不同的例子。示例不能只证明提示词能处理已经展示过的写法。
Lilian Weng 的提示词综述 梳理了示例选择、标签分布和排列顺序的研究。迁移到具体任务时,可以固定例子内容、交换顺序,或者移除某个例子,观察哪类错误随之变化。这比不断加入更多例子更容易解释结果。
还要控制示例与测试数据的关系。已展示的案例以及它的近似改写,不能再作为独立测试来证明泛化。来自同一模板、同一文档或同一事件的样本,通常应按组划分,避免改几个词就进入另一侧的数据集。
从 Zero-shot 基线起步,按错误增加示例
不存在适用于所有任务的最佳示例数量。Claude 提示词指南 给出了少量、多样示例的经验建议;OpenAI 推理模型指南 则建议先尝试零样例,再按需增加。这些建议针对的模型和使用场景不同。
可以先只写清楚规则,检查真实错误。模型若已经理解任务,再加例子可能只增加输入成本;若持续混淆某类边界,就加入能够解释该边界的例子。每个例子最好回答一个问题:删除它以后,哪类失败会重新出现?
示例还会影响答案长度与形式。若所有示例都写了长篇解释,即使正文要求简短,输出仍可能偏长。需要短输出时,示例也应短;需要保留未知状态时,示例中就应出现合理的未知,而不是每一道都有完整答案。
四、按任务选择推理与分解
思维链(CoT):示范怎样得到答案
Chain-of-Thought Prompting 展示了带中间解题过程的示例,在部分大语言模型和推理任务上的收益。原始方法不等同于在任意任务末尾附加一句“请逐步思考”,其效果也不是跨任务保证。
原论文图 1 用网球和苹果说明这个区别。以下是提示结构的中文压缩转述:
已完成示例
问:Roger 原有 5 个网球,又买了 2 罐,每罐 3 个,现在多少个?
答:新增 2 × 3 = 6 个;总共 5 + 6 = 11 个。

新任务
问:食堂原有 23 个苹果,午餐用了 20 个,又买了 6 个,还剩多少?
答:
示例展示了数量关系和运算,而不只是答案 11。新题对应 23 − 20 + 6 = 9。图中只展示一条示例来解释方法,主体实验使用了更完整的示例集;单个成功案例不能替代总体评测。
不给解题示例、附加“Let’s think step by step”的写法,属于另一项研究中的 Zero-shot CoT。其原始流程先生成解答,再抽取最终答案。它与带解题示例的 CoT 有不同的输入结构,不能混为同一句口诀。
对已经训练了内部推理能力的模型,额外强制输出很长的思考过程未必有帮助。OpenAI 面向推理模型的指南更强调直接说明目标和约束。模型版本变化后,旧提示中的反复检查、强制分步和过长角色设定都值得重新评估。
仍然可以要求有用的解释:关键假设、计算公式、证据引用、简短决策理由,或者面向学习者的解题步骤。这些应是服务于读者的交付物。解释写得连贯,只能说明它易读;不能单凭这段文字证明答案正确,也不能据此推断模型真实的内部过程。
Least-to-Most:让后一步复用前一步
“先分析,再思考,再回答”几乎没有定义中间工作。更具体的分解会说明每一步接收什么、产生什么、怎样继续。Least-to-Most Prompting 将问题分解为子问题,再利用已有子答案顺序求解;其思想适合启发流程设计,开放任务中的分解质量仍需要单独判断。
论文中的末字母拼接任务,直观地展示了这种依赖。下面压缩转述原文的演示:
任务:依次取 think、machine、learning 的末字母并拼接。
基本结果:think、machine 的末字母为 k、e,得到 ke。
继续求解:已有 ke;learning 的末字母为 g。
最终结果:ke + g = keg。
后一步使用了前一步的产物,而无需从头重新处理整份列表。这个例子适合解释递推与依赖;实际应用里,末字母操作可以直接用程序完成,不必为了使用提示词方法而调用模型。
比较两份技术方案时,可以拆成以下产物:
1. 从需求中提取必须满足的条件,保留原始条目编号。
2. 分别从方案 A、B 提取对应证据;没有证据的项标为未知。
3. 对齐条件与证据,区分满足、不满足、无法判断。
4. 根据用户给定的优先级形成建议,列出影响建议的未知项。
检查:全部必须条件均出现在对照表中。
这些步骤可以在一次调用里完成,也可以拆成多次调用。将调用串联、让后一调用消费前一步产物,是 Prompt chaining;Anthropic 的工作流指南也强调可以在调用之间加入程序检查。需要独立检查、复用、并行处理或更换工具时,多次调用才有明确收益。任务本来很短,却先生成一份复杂计划,往往只增加延迟和新的出错位置。
分解还会引入信息丢失。若第一步漏掉一条需求,后续对照表可能整齐地沿用错误。需要保留原始条目编号,并在最后检查覆盖情况。凡是下游只看到摘要、看不到原文的地方,都应考虑摘要是否丢掉了否定、例外和适用条件。
Self-Consistency:多次采样怎样选择答案
Self-Consistency 通过采样多条推理路径,再对最终答案进行聚合,在其测试任务中改善了结果。它依赖可比较的最终答案;开放式报告并不存在天然的多数票。
用于数值或选择题时,应先规范化答案:单位是否一致,百分数与小数是否等价,同义标签是否需要合并。若多条样本共同误读题意,投票也会稳定地产生错误。样本之间可能共享系统性偏差,票数不能直接解释成正确概率。
records = []
for candidate in sample(task, budget=n):
    records.append({
        answer: normalize(candidate.final_answer),
        checks: check_with_available_rules(candidate)
    })
return select_or_report_disagreement(records)
选择策略可以是可验证测试、人工比较,或适合该任务的聚合规则。能够运行测试的代码,通常应先看测试结果;能用精确计算复核的数字,应先复核计算。比较方法时还应使用相近的总预算,避免把多调用带来的收益全部归因于某一句提示。
ReAct:让工具观察决定下一步
有些问题需要先找到一个事实,才能确定接下来查什么。ReAct 将推理、动作与环境观察交替组织。它的 HotpotQA 提示中有一个经典示例:先确定造山运动延伸到哪个地区,再查该地区的海拔,并处理同名歧义。查询轨迹可以压缩转述为:
问题:科罗拉多造山运动东部延伸地区的海拔范围是多少?
查询 Colorado orogeny:当前摘要未说明东部延伸地区。
在条目中查找 eastern sector:得到地区名 High Plains。
查询 High Plains:返回同名地区的消歧信息。
改查 High Plains (United States):得到海拔范围。
示例答案:1,800–7,000 英尺。
后续查询随观察调整:摘要没有所需信息,就查条目;遇到歧义,就补充实体限定。若一开始就把全部查询列完、后续不再读取反馈,就容易遗漏这类中间变化。
原始 ReAct 提示示范了推理、动作和观察的轨迹。当前接口可以使用原生工具调用,让模型提出函数与参数,由应用执行并送回结果,具体分工可见 Gemini function calling 指南。需要保留的是基于实际结果继续决策的循环,不必要求当前推理模型公开逐字内部思考。
工具观察必须来自真实执行。让模型在一次回答中续写“搜索结果”,不会产生搜索能力;重复查询、错误检索和误读材料也仍会失败。因此循环需要调用预算、无结果时的退出行为,以及宿主程序负责的权限和参数检查。
五、让输出可以检查和继续使用
Structured Outputs:约定格式与未完成状态
给人阅读时,简洁的标题和表格通常已经够用。下游需要程序处理时,可以使用接口支持的结构化输出,避免只靠“请只输出 JSON”维持格式。OpenAI Structured Outputs 和 Gemini Structured Output 都区分了结构约束与内容正确性。
输出设计尤其要给未知留下位置。若要求每个字段都有一个看似正常的值,模型面对不相容的输入时就可能被迫补写。必要字段可以表示状态,事实字段可以为空,缺项应有明确含义。
{
  "status": "needs_info",
  "category": null,
  "missing_fields": ["expected_result"],
  "evidence_ids": ["ticket:P2"]
}
这个例子表达了本次分类尚不能完成;具体字段组合仍需要程序检查。API 拒绝、输出截断和内容无法判断也是不同情况,不能都当成一个合法 JSON 对象继续处理。
Schema 适合检查类型、必需字段和枚举。日期先后关系、单位换算、来源对应关系和业务状态,需要额外校验。字段叫 verified 并且值为 true,只说明模型生成了这个值;它不能代替实际执行的验证。
引用存在、引用支持结论,要分别判断
一条引用至少有三个不同问题:原文是否出现过,引用是否支持这句话,来源是否适用于当前问题。它们不能用同一个“有引用”指标概括。Jason Liu 的引用验证文章展示了原文匹配与语义一致性检查;实际应用还应检查来源的版本和适用范围。
例如,原文“该接口目前只在测试环境开放”,不能支持“该接口已向所有用户开放”。引用完全匹配,结论仍然错误。另一个常见问题是范围扩大:材料只覆盖一组样本,答案却写成普遍规律;材料只有相关关系,答案却改成因果关系。
可以先用程序检查来源 ID、版本和原文片段,再对关键结论进行语义核验。语义检查应允许“证据不足”,并保留需要专家判断的部分。使用另一个模型审核时,还要观察它对真实错误的识别能力,不能把审核模型当成默认正确的裁判。
对高密度材料,可以将每条关键判断与证据绑定成记录,再生成面向人的正文。这样修订结论时能定位所依赖的来源,最终文字也不必充满冗长的检验过程。
修复应当接收具体反馈,并设置停止条件
“再仔细检查三遍”没有说明检查依据。Large Language Models Cannot Self-Correct Reasoning Yet 在所测试模型与任务中发现,缺少外部反馈的自我修正不可靠,甚至可能把正确答案改错。这个结果不能概括所有新模型,也不否定测试、检索和专家反馈支持的修复。
有用的反馈应指出哪条要求失败、错误位于哪里、已知正确的信息是什么。例如“第 3 项引用不在 D2 中”“应返回 8 个条目,目前只有 7 个”“日期早于允许范围”。只反馈“质量不够高”,模型很可能只是改写语气。
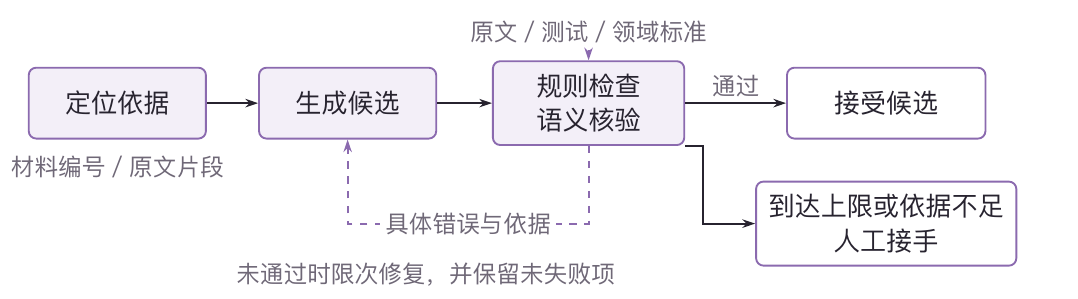
candidate = generate(task, materials, requirements, output_spec)
for attempt in range(max_repairs + 1):
    checks = validate(candidate, materials, requirements, output_spec)
    if checks.accepted:
        return candidate
    if attempt == max_repairs or checks.requires_new_information:
        return needs_review(candidate, checks)
    candidate = repair(
        candidate, task, materials,
        requirements, output_spec, checks.details
    )
修复后应重新运行相关检查,避免改好一处、破坏另一处。来源本身缺失时,应补资料或返回待核查;不能要求模型不断重写,直到生成一个恰好满足表面约束的答案。停止条件决定了这套流程是否会把“不知道”磨成“看起来知道”。
六、根据错误改提示词
调试实际请求,而不只看模板
应用真正发送给模型的内容,可能包含模板没有展示的历史消息、工具定义、检索片段、Schema 和重试反馈。Hamel Husain 在关于查看实际提示的文章中强调了这一点:只检查手写字符串,很容易调错对象。
“模型忽略了规则”可能是资料被截断、历史中残留旧要求、框架自动加入了冲突说明,或者模板插值把段落层级打乱。先还原那次运行的实际请求和响应,再决定改哪一层。包含敏感资料的记录,应按原有数据权限保存和展示。
一个可复现记录至少包含提示模板版本、实际输入、模型版本、生成设置和返回状态。涉及多次调用时,还要保留调用顺序与每步产物。最终得到的答案相同,并不意味着执行成本和中间行为相同。
每次修改都带一个可验证的假设
看到坏答案就追加一条“绝对不要”,很快会得到相互重叠、甚至冲突的长提示。更有效的做法是先归因:目标不清、依据不足、例子偏置、格式不稳、推理错误,还是校验逻辑有问题。
Hamel Husain 的错误分析方法强调从真实交互中观察、归类并形成测试。Simon Willison 对提示词工程的讨论也将沟通和实验作为核心。可以把这两点落实为一张修改记录:
现象:信息不足的工单被强行分类。
假设:规则只定义了 bug 和 feature,没有可返回的未知状态。
改动:增加 needs_info,并添加一个缺项样例。
观察:此类误判是否减少;明确工单的完成率是否下降。
回归:原先可正确区分的相邻类别是否仍然正确。
尽量让一次实验回答一个问题。要确认示例有用,就保持其他条件不变;要比较示例顺序,就不同时换模型和标签定义。复杂改动可以整体比较,但结论只能是整组改动的效果,不能单独归功于其中某句话。
删除也是重要的实验。去掉复杂角色、重复规则或某个例子,结果没有变差,就可以考虑精简。保留下来的内容应有明确用途,而不只是曾经与一次成功同时出现。
同时观察正确、完整与合理的不作答
评测应覆盖常见输入、容易混淆的边界、信息不足和资料冲突。开发样本用于诊断与修改,留出样本用于检查修改能否迁移。反复根据同一批留出结果调整提示,它们就逐渐成为了开发数据,需要新的独立检验。
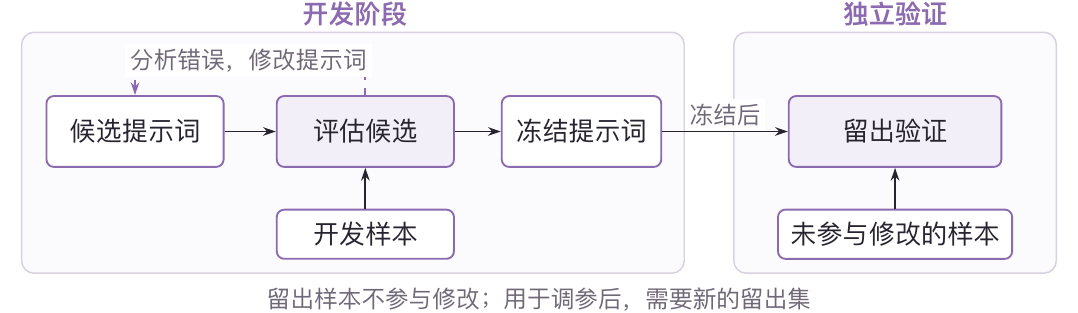
IFEval 区分单项指令遵循与整条请求的全部指令遵循。实际应用也需要这种区分:一个答案可能格式正确、长度合规,却漏掉必答问题。单项平均分高,不一定代表最终交付物可用。
只观察已回答部分的正确率,也可能鼓励模型大量返回未知。应同时记录哪些问题被回答、哪些被拒答或交回澄清,以及这些决定是否合理。对资料本来齐全的任务,不必要的弃答是一种失败;对关键依据缺失的任务,强行回答同样是失败。
可以先采用少量、明确的检查项,分别观察关键子类,不必立即合成一个总分。语义评分器需要用专家判断校准,尤其要看它是否奖励了更长的答案。对有随机波动的任务,在合理预算内重复运行,同时记录完成率、全部尝试的总成本,以及获得可接受结果所需的端到端延迟;失败调用和修复也计入。OpenAI 评测指南提供了相关实践建议。
自动优化依赖一份值得优化的目标
自动方法可以搜索指令、挑选示例,甚至优化多步程序。DSPy 将语言模型程序与数据、评价指标结合;其优化器文档说明了候选指令与示例的搜索方式。这有助于减少手工尝试,但评价目标仍由任务决定。
如果指标只检查格式,优化器可以得到格式稳定、内容空泛的答案;如果奖励每项都有值,就可能压低合理的未知比例。自动优化会放大目标中的偏好,因此指标和错误样本应先经过实际审视。
Hamel Husain 与 Shreya Shankar 在关于手工提示与自动工具的讨论中强调,手工处理真实案例有助于暴露假设、建立评价标准。更合理的顺序是先理解错误,再用自动方法扩大候选搜索,并继续检查指标没有覆盖的新失败。
七、判断何时该停止改措辞
缺知识、计算和权限时,调整对应系统
模型没有获得最新资料,要求“务必最新”不会补上信息;没有计算工具,要求“绝对精确”也不会形成精确计算;没有访问接口,写“请联网核实”不能让核实真正发生。提示词可以规定何时检索、计算和报告缺项,系统需要提供这些能力并保存实际结果。
有些要求更适合直接由程序执行。固定排序、精确计数、字段去重和可明确表达的关系检查,通常无需依靠模型每次重新理解。内容生成交给模型,确定性规则交给程序,可以减少提示词中不断累积的细节。
模型生成的自评也要审慎使用。“置信度 95%”不是天然校准过的概率;“已检查”不是实际工具回执。需要这些信号时,应通过任务数据验证它们与错误的关系,或直接使用可核对的来源、测试结果和执行记录。
将提示词与模型、设置一起验证
提示词的表现依赖模型。新版本可能更擅长遵循短指令,也可能对旧示例和强制推理写法产生不同反应。DeepSeek-R1 的技术报告在其设置中讨论了零样例与少样例的差异;这说明需要重建基线,不能推断所有推理模型都应移除示例。
采样参数同样没有通用答案。降低温度会改变采样行为,但不保证事实更正确,也不承诺完全确定的重现。Gemini 提示词指南中的模型专属建议也显示,沿用旧参数口诀可能不合适。
迁移时应同时测试现有提示和一个精简基线,比较任务正确性、边界行为、成本与延迟。提示模板、示例集、模型版本、生成设置和评测样本应作为一组记录。只记一句最终提示,通常不足以解释以后为什么表现变了。
按现象查阅
| 遇到的现象 | 优先检查与调整 |
|---|---|
| 想先弄清 Zero-shot、One-shot 与 Few-shot 的区别 | 输入结构对照:区分任务输入与已完成的演示,看新词造句案例 |
| 答案流畅,却不适合实际用途 | 交付物与受众:说明谁要用、用来做什么,再确定内容取舍 |
| 输出满足格式,却漏掉重要内容 | 约束与优先级、整体验收:分别检查完整性与单项规则 |
| 信息不足仍给出确定结论 | 缺项处理、输出状态:提供未知、澄清和无法完成的表达 |
| 长资料里的关键依据被漏用 | 长上下文:保留定位信息,移动证据位置并加入干扰内容测试 |
| 分类总在相邻类别之间混淆 | Few-shot 示例边界:增加相似输入、不同结论的正确样例 |
| 换几个示例或顺序,结果明显变化 | 示例偏置:检查偶然关键词、标签分布、顺序与测试泄漏 |
| 推理越来越长,正确性没有提高 | CoT、Least-to-Most 与调用分解:保留必要解释,减少无依据的强制步骤 |
| 多个答案一致,但共同犯错 | Self-Consistency:检查共同假设,用外部规则验证后再聚合 |
| 下一步检索依赖刚刚查到的信息 | ReAct:真实执行工具,再根据观察调整查询;保留预算和退出条件 |
| 有引用,但引用与结论不相符 | 证据检查:区分原文存在、语义支持与适用范围 |
| 反复自检,只得到不同措辞 | 限次修复:回传具体错误,缺资料时停止重写 |
| 模板看起来正确,应用里却不稳定 | 实际请求:查看消息、检索、工具定义、截断与重试内容 |
| 提示越来越长,新问题仍不断出现 | 修改假设、职责边界:做删除实验,判断是否需要改数据或程序 |
| 换模型后,原来的技巧反而拖累效果 | 版本验证:重新比较精简基线与现有提示 |
提示词值得保留的细节,应能说明它消除了什么歧义、减少了哪类错误,以及怎样检查。这样积累下来的规则、示例和测试,才方便在任务变化或模型升级后继续修订。